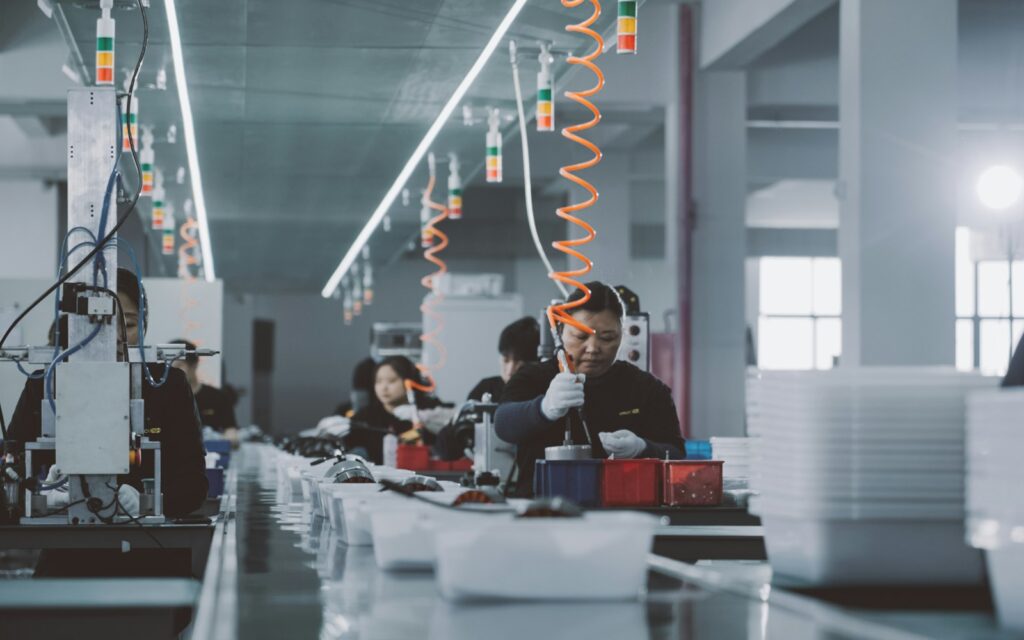
Edge Computing entscheidet in vielen Fabrikhallen längst darüber, ob eine Maschine rechtzeitig stoppt oder ein fehlerhaftes Bauteil erst am Ende der Linie auffällt. Eine Kamera prüft jedes Werkstück, ein kleiner Rechner direkt neben dem Band wertet das Bild aus, und die Entscheidung fällt in Millisekunden. Den Umweg über ein entferntes Rechenzentrum würde die Linie schlicht nicht abwarten.
Genau hier liegt der Kern des Konzepts: Rechenleistung wandert dorthin, wo Daten entstehen. Das klingt nach einem Nischenthema für Ingenieure, betrifft aber Handel, Logistik, Energieversorgung und zunehmend jede Firma, die Sensoren, Kameras oder KI im Alltag einsetzt.
Dieser Beitrag erklärt dir Edge Computing einfach und ohne Fachjargon: wie die Architektur aufgebaut ist, wo sich der Ansatz wirtschaftlich lohnt, welche Risiken du im Blick behalten musst und wie du ein erstes Projekt strukturiert aufsetzt.
Inhaltsverzeichnis
Was ist Edge Computing?
Edge Computing bezeichnet die Verarbeitung von Daten am Rand des Netzwerks, also nah an der Quelle: an der Maschine, im Fahrzeug, in der Filiale oder im Mobilfunkmast. Statt alle Rohdaten in eine zentrale Cloud zu schicken, filtern, analysieren und beantworten lokale Rechner sie direkt vor Ort. Nur verdichtete Ergebnisse wandern weiter ins Rechenzentrum.
Der Begriff „Edge“ meint dabei keinen festen Ort, sondern eine Position im Datenfluss. Für ein Windrad ist die Edge der Steuerrechner in der Gondel. Für einen Mobilfunkanbieter ist es der Server am Basisstationsstandort, für eine Supermarktkette der kleine Serverschrank im Lager der Filiale.
Wichtig für das Verständnis: Die Edge ersetzt die Cloud nicht. Beide Welten ergänzen sich. Die Cloud bleibt der Ort für Training, Archivierung, übergreifende Auswertungen und zentrale Verwaltung, die Edge übernimmt alles, was schnell, lokal oder datensparsam passieren muss.
Wie funktioniert Edge Computing in der Praxis?
Technisch besteht eine Edge-Architektur meist aus drei Schichten, die zusammenarbeiten. Je nach Branche heißen sie unterschiedlich, das Prinzip bleibt gleich.
- Geräteebene: Sensoren, Kameras, Steuerungen, Kassen oder Fahrzeuge erzeugen Daten. Manche Geräte rechnen bereits selbst, etwa smarte Kameras mit eingebautem KI-Chip.
- Edge-Ebene: Gateways, Industrie-PCs oder kompakte Server bündeln die Daten mehrerer Geräte, führen Anwendungen aus und treffen lokale Entscheidungen.
- Cloud- oder Rechenzentrumsebene: Hier laufen Verwaltung, Langzeitspeicherung, Modelltraining und unternehmensweite Analysen.
Zwischen den Ebenen fließen Daten in beide Richtungen. Nach oben gehen aggregierte Messwerte, Ereignisse und Ausnahmen. Nach unten kommen Software-Updates, neue KI-Modelle und Konfigurationen, die zentral verteilt werden.
Software am Rand: Container und zentrale Steuerung
Auf der Softwareseite hat sich ein Muster durchgesetzt, das du aus der Cloud kennst: Anwendungen laufen in Containern, also in standardisierten Paketen mit allen nötigen Abhängigkeiten. Schlanke Varianten bekannter Orchestrierungswerkzeuge sind speziell für kleine Rechner mit wenig Arbeitsspeicher gebaut.
Der Vorteil liegt im Betrieb. Eine neue Version der Bildauswertung wird einmal zentral freigegeben und dann automatisch auf alle Standorte verteilt. Geht etwas schief, rollt die Plattform die alte Version zurück, ohne dass jemand vor Ort eingreifen muss.
Viele Cloud-Anbieter und Hardwarehersteller bieten dafür eigene Edge-Plattformen an. Prüfe bei der Auswahl, wie offen die Lösung ist und ob du Anwendungen später auch auf andere Hardware oder in ein anderes Rechenzentrum umziehen kannst.
Edge, Fog und Cloud: die Abgrenzung
Neben Edge Computing begegnet dir häufig der Begriff Fog Computing. Er beschreibt eine Zwischenschicht, die mehrere Edge-Standorte regional bündelt, etwa ein Mini-Rechenzentrum für ein ganzes Werksgelände. In der Praxis verschwimmen die Grenzen, viele Anbieter fassen beides unter „Edge“ zusammen.
Ein weiterer Spezialfall ist Multi-access Edge Computing (MEC). Hier stellen Netzbetreiber Rechenkapazität direkt in ihrem Mobilfunknetz bereit. Das Standardisierungsgremium ETSI beschreibt den Ansatz auf seiner Themenseite zu Multi-access Edge Computing. Für Unternehmen mit eigenem privatem 5G-Campusnetz lassen sich solche Edge-Server sogar auf dem eigenen Gelände betreiben.
Warum Latenz der entscheidende Faktor ist
Latenz ist die Zeit, die ein Datenpaket für Hin- und Rückweg braucht. Jede Strecke über das Internet kostet Zeit, und jede zusätzliche Station erhöht das Risiko von Verzögerungen. Für ein Dashboard spielt das kaum eine Rolle, für eine Robotersteuerung oder eine Kollisionswarnung dagegen schon.
Die lokale Verarbeitung verkürzt den Weg radikal. Die Entscheidung fällt im selben Gebäude oder sogar im selben Gerät. Das macht Anwendungen planbar, weil sie nicht von der Qualität der Internetverbindung abhängen.
Warum Unternehmen auf Edge Computing setzen
Die Entscheidung für Rechnen am Rand ist selten eine reine Technikfrage. Meist treiben handfeste betriebliche Gründe das Thema, und oft kommen mehrere davon zusammen.
- Reaktionszeit: Prozesse, die in Echtzeit reagieren müssen, laufen lokal zuverlässiger als über eine entfernte Cloud.
- Bandbreite und Kosten: Hochauflösende Kameras und dichte Sensorik erzeugen enorme Datenmengen. Wer nur Ergebnisse überträgt, spart Leitungskapazität und Cloud-Speicher.
- Ausfallsicherheit: Fällt die Internetverbindung aus, arbeitet die Edge weiter. Kassen, Maschinen und Zutrittssysteme bleiben handlungsfähig.
- Datenschutz und Datensouveränität: Personenbezogene Bilder oder sensible Produktionsdaten können vor Ort anonymisiert oder ganz lokal gehalten werden.
- Skalierung: Neue Standorte lassen sich mit standardisierten Edge-Paketen schnell anbinden, statt jedes Mal individuelle Lösungen zu bauen.
Beispielrechnung: Eine Fertigungslinie hat zehn Kameras, die rund um die Uhr Videobilder liefern. Würden alle Streams dauerhaft in die Cloud wandern, bräuchtest du eine sehr breite Leitung und zahlst für Übertragung und Speicher jedes einzelnen Bildes. Wertet ein lokaler Rechner die Bilder aus und meldet nur ein Prüfergebnis pro Bauteil plus Fotos der Ausschussteile, schrumpft der Datenverkehr auf einen kleinen Bruchteil.
Gerade der Kostenaspekt wird häufig unterschätzt. Viele Unternehmen merken erst bei der Cloud-Rechnung, wie teuer der dauerhafte Transfer großer Datenmengen wird. Edge Computing ist deshalb oft Teil einer breiteren Debatte über die Rückholung von Workloads aus der Public Cloud.
Typische Einsatzfelder von Edge Computing
Die Bandbreite der Anwendungen ist groß. Einige Muster tauchen aber in fast allen Branchen auf und eignen sich gut als Orientierung für dein eigenes Unternehmen.
Industrie und Fertigung
In der Produktion ist Edge Computing besonders weit verbreitet. Optische Qualitätsprüfung, Zustandsüberwachung von Antrieben und vorausschauende Wartung leben davon, dass Daten in hoher Frequenz direkt an der Maschine ausgewertet werden. Die Cloud erhält nur Auffälligkeiten und Trends.
Hinzu kommt ein praktischer Punkt: Viele Werke trennen ihr Produktionsnetz bewusst vom Büronetz. Eine lokale Edge-Plattform passt gut in diese Segmentierung, weil sie Daten aufbereitet, bevor sie kontrolliert nach außen gehen.
Handel und Filialen
Im stationären Handel laufen Kassensysteme, Warenwirtschaft, digitale Preisschilder und Videoanalysen parallel. Ein Edge-Server in der Filiale hält den Betrieb am Laufen, auch wenn die Verbindung zur Zentrale wackelt. Gleichzeitig lassen sich Auswertungen wie Kundenfrequenz direkt vor Ort anonymisieren.
Logistik, Energie und Gesundheitswesen
In Lagern steuern Edge-Systeme autonome Transportfahrzeuge und Scanner. Energieversorger nutzen lokale Rechner in Umspannwerken und Erzeugungsanlagen, um Netze stabil zu halten. Im Gesundheitswesen werten Geräte Vitaldaten nah am Patienten aus, wobei hier besonders strenge Anforderungen an Sicherheit und Medizinprodukterecht gelten.
Edge Computing und KI: Intelligenz direkt vor Ort
Der stärkste Treiber der vergangenen Jahre ist künstliche Intelligenz. Das Training großer Modelle bleibt Aufgabe leistungsstarker Rechenzentren. Die Anwendung trainierter Modelle, die sogenannte Inferenz, lässt sich dagegen zunehmend auf kompakte Hardware am Rand verlagern.
Spezialisierte KI-Beschleuniger in Industrie-PCs, Kameras und Gateways machen das möglich. Eine Kamera erkennt Kratzer, ein Gateway prognostiziert Lagerschäden, ein kleiner Server beantwortet Fragen zu Wartungshandbüchern. Wer tiefer einsteigen will, findet im Beitrag über lokale KI und kleine Sprachmodelle auf eigenen Servern einen guten Überblick.
Edge-KI bringt aber eigene Fragen mit. Modelle müssen versioniert, verteilt und überwacht werden, und zwar an Dutzenden oder Hunderten Standorten. Ohne zentrales Management entsteht schnell ein Flickenteppich unterschiedlicher Softwarestände.
Risiken und Grenzen von Edge Computing
So überzeugend die Vorteile klingen: Edge Computing verlagert Komplexität. Statt eines zentralen Rechenzentrums betreibst du viele kleine Standorte, die oft ohne IT-Personal vor Ort auskommen müssen.
Sicherheit an verteilten Standorten
Jeder Edge-Knoten vergrößert die Angriffsfläche. Geräte stehen in Hallen, Filialen oder Schaltschränken, wo sie physisch zugänglich sind. Deshalb brauchst du verschlüsselte Datenträger, sichere Boot-Prozesse, starke Identitäten für Geräte und ein konsequentes Patch-Management.
Ein bewährter Ansatz ist, jedem Gerät und jeder Verbindung grundsätzlich zu misstrauen und Zugriffe einzeln zu prüfen. Orientierung zu Grundschutz und Härtung bietet das Bundesamt für Sicherheit in der Informationstechnik (BSI). Falls dein Unternehmen unter NIS2 fällt, gehören Edge-Standorte ausdrücklich in dein Risikomanagement.
Betrieb, Kosten und Fachkräfte
Hardware am Rand muss robust sein: Staub, Hitze, Vibrationen und Stromschwankungen setzen ihr zu. Austausch und Wartung kosten Zeit, wenn Techniker anreisen müssen. Plane deshalb Fernwartung, standardisierte Hardware und einfache Austauschprozesse von Anfang an ein.
Auch personell ist Edge Computing anspruchsvoll. Du brauchst Know-how aus IT, Netzwerktechnik und oft auch Automatisierungstechnik. Diese Kombination ist am Arbeitsmarkt knapp, weshalb viele Unternehmen mit Integratoren oder Managed-Service-Anbietern arbeiten.
Wann sich Edge Computing nicht lohnt
Nicht jede Anwendung gehört an den Rand. Klassische Büroanwendungen, Buchhaltung, CRM oder Reporting laufen in der Cloud oder im zentralen Rechenzentrum meist einfacher und günstiger. Wenn Latenz keine Rolle spielt, Datenmengen überschaubar bleiben und die Verbindung stabil ist, bringt Edge Computing vor allem zusätzlichen Aufwand.
Wie startest du mit Edge Computing im Unternehmen?
Ein Edge-Projekt gelingt am besten, wenn du klein und messbar beginnst. Die folgenden Schritte haben sich als Struktur bewährt:
- Identifiziere einen konkreten Anwendungsfall mit klarem Nutzen, etwa Ausschuss senken, Stillstände verkürzen oder Datenkosten reduzieren.
- Prüfe die Anforderungen: Welche Reaktionszeit ist nötig, welche Datenmengen entstehen, was passiert bei einem Verbindungsausfall?
- Definiere die Architektur und lege fest, welche Daten lokal bleiben und welche in die Cloud wandern.
- Wähle standardisierte Hardware und eine Plattform für zentrales Management, Updates und Monitoring aller Standorte.
- Verankere Sicherheit von Beginn an: Geräteidentitäten, Verschlüsselung, Netzsegmentierung und Zuständigkeiten für Patches.
- Teste den Ansatz in einem Pilotstandort und miss Kennzahlen wie Verfügbarkeit, Reaktionszeit und Betriebsaufwand.
- Skaliere erst nach einer ehrlichen Bewertung und rolle das Konzept als Paket auf weitere Standorte aus.
Achte darauf, Fachabteilungen früh einzubinden. Ein Edge-Projekt in der Produktion scheitert selten an der Technik, sondern häufiger an unklaren Verantwortlichkeiten zwischen IT und Betrieb.
Kernfragen für Entscheider
- Welcher Prozess verliert heute Geld oder Qualität, weil Daten zu langsam ausgewertet werden?
- Wer betreibt die Edge-Knoten im Alltag: IT, Produktion oder ein externer Dienstleister?
- Wie sieht die Kostenrechnung über mehrere Jahre aus, inklusive Austausch und Wartung?
- Welche regulatorischen Pflichten, etwa aus Datenschutz oder NIS2, betreffen die Standorte?
Fazit: Edge Computing ist ein Werkzeug, kein Selbstzweck
Edge Computing bringt Rechenleistung dorthin, wo Daten entstehen und Entscheidungen schnell fallen müssen. Für Fertigung, Handel, Logistik und Energie ist der Ansatz längst Alltag, und mit Edge-KI wächst sein Einsatzgebiet weiter.
Gleichzeitig verschiebt Edge Computing Verantwortung: Sicherheit, Betrieb und Updates verteilen sich auf viele Standorte. Erfolgreich sind Unternehmen, die mit einem klaren Anwendungsfall starten, Cloud und Edge als Einheit planen und den Betrieb von Anfang an standardisieren.
Stand Oktober 2026 gilt: Die Technik ist reif, die Herausforderung liegt in Organisation und Betrieb. Wenn du diese Punkte sauber klärst, wird Edge Computing zum handfesten Wettbewerbsvorteil.
Häufige Fragen zu Edge Computing
Was ist Edge Computing einfach erklärt?
Edge Computing bedeutet, dass Daten nicht erst in eine entfernte Cloud geschickt, sondern direkt dort verarbeitet werden, wo sie entstehen: an der Maschine, in der Filiale oder im Fahrzeug. Lokale Rechner werten die Daten aus und treffen schnelle Entscheidungen. In die Cloud gelangen nur noch verdichtete Ergebnisse, was Zeit, Bandbreite und oft auch Kosten spart.
Wie unterscheidet sich Edge Computing von Cloud Computing?
Cloud Computing bündelt Rechenleistung in großen, zentralen Rechenzentren. Edge Computing verteilt Rechenleistung auf viele kleine Standorte nah an der Datenquelle. Beide Ansätze ergänzen sich: Die Edge übernimmt zeitkritische und lokale Aufgaben, die Cloud kümmert sich um Training von KI-Modellen, Archivierung, zentrale Verwaltung und unternehmensweite Analysen.
Welche Vorteile bringt Edge Computing für Unternehmen?
Die wichtigsten Vorteile sind kurze Reaktionszeiten, geringere Datenübertragung, höhere Ausfallsicherheit und mehr Kontrolle über sensible Daten. Prozesse laufen auch bei einer gestörten Internetverbindung weiter. Zudem lassen sich personenbezogene Daten vor Ort anonymisieren, bevor sie das Gelände verlassen. Das erleichtert die Einhaltung von Datenschutzvorgaben und senkt laufende Cloud-Kosten.
Warum ist Sicherheit bei Edge-Standorten besonders wichtig?
Edge-Geräte stehen oft in Hallen, Filialen oder Schaltschränken und sind dort physisch zugänglich. Jeder zusätzliche Standort vergrößert die Angriffsfläche. Deshalb sind verschlüsselte Datenträger, sichere Boot-Prozesse, eindeutige Geräteidentitäten, Netzsegmentierung und ein zentrales Patch-Management Pflicht. Fällt dein Unternehmen unter NIS2, gehören Edge-Standorte zudem ins Risikomanagement.
Wann lohnt sich Edge Computing nicht?
Edge Computing lohnt sich kaum, wenn Latenz keine Rolle spielt, die Datenmengen klein sind und die Internetverbindung stabil ist. Typische Büroanwendungen wie Buchhaltung, CRM oder Reporting laufen zentral einfacher und günstiger. In solchen Fällen erzeugt eine verteilte Infrastruktur vor allem zusätzlichen Aufwand für Betrieb, Wartung und Sicherheit, ohne messbaren Mehrwert.